贝叶斯分类器(朴素贝叶斯)的实例应用——以品种鉴定为例

什么是贝叶斯分类器?
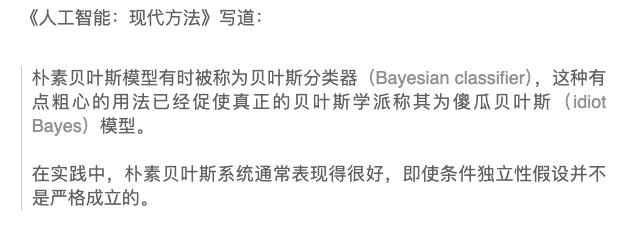
image.png

贝叶斯分类器

解释说明

1. 三个概率是谁是谁

贝叶斯公式:P(yi∣x)=P(x∣yi)P(yi)P(x).

分母 P(x) 对所有类别都一样,所以**做“谁最大就选谁”**时可以忽略,只比分子大小。

2. “朴素”两个字从哪来

直接算 P(x∣yi) 很难,因为 x 可能有很多维。朴素贝叶斯假设:

在给定类别的条件下,各特征相互独立

于是

P(x∣yi)=∏k=1nP(xk∣yi).

带回去就得到决策规则:

y^=arg⁡maxyiP(yi)∏k=1nP(xk∣yi).

实际实现中,为了防止下溢,一般取对数:

\hat y=\arg\max_{y_i}\; \log P(y_i)+\sum_{k=1}^{n}\log P(x_k\mid y_i)$$. 这条规则在**0-1 损失**下是**最小错误率的最优**(Bayes 最优决策):谁的后验概率最大就选谁,等价于最小化误判概率。 ### **3. 这些概率从哪来(训练阶段)** - $P(y_i)$:各类样本数占比。 - $P(x_k\mid y_i)$:看每一类 $y_i$ 下,第 $k$ 个特征的统计。 - **离散/二元特征**:频率估计,加 **拉普拉斯平滑**(避免 0):

\hat P(x_k=a\mid y_i)=\frac{\text{count}(x_k=a, y_i)+\alpha}{\text{count}(y_i)+\alpha\cdot |\mathcal{A}_k|}

- **连续特征**:常用 **高斯朴素贝叶斯**,假设 $x_k\mid y_i\sim \mathcal{N}(\mu_{ki},\sigma^2_{ki})$,把密度带进上面求和(用 log)。 ### **4. 一个 30 秒小例子** 二分类:$y\in\{\text{spam},\text{ham}\}$。两个二值特征: - $x_1$:是否含“win” - $x_2$:是否含“meeting” 训练数出来: $P(\text{spam})=0.4,$; $P(\text{ham})=0.6$ - $P(x_1=\text{是}\mid \text{spam})=0.8,$\; $P(x_1=\text{是}\mid \text{ham})=0.1$ - $P(x_2=\text{是}\mid \text{spam})=0.2,$\; $P(x_2=\text{是}\mid \text{ham})=0.6$ 现在这封邮件 $x=(x_1=\text{是},x_2=\text{是})$: - spam 分子:$0.4\times 0.8\times 0.2=0.064$ - ham 分子:$0.6\times 0.1\times 0.6=0.036$ 0.064 > 0.036 ⇒ 判为 **spam**。分母 P(x) 不用算,因为它对两类都一样。 ### **5. 常见坑 & 实战要点** - **强相关特征**会被“重复计算”增强或削弱证据(例如同义词、多列高度相关指标)。可做特征选择/去相关,或改用别的模型。 - **零概率**(训练中没见过):务必做**拉普拉斯/加一平滑**。 - **类别极不均衡**:先验 P(y_i) 会主导,必要时重采样或调权。 - **输出概率的“标定”**:朴素贝叶斯后验往往不校准,可用 Platt/Isotonic 做校准。 ### **6. 跟你的领域(品种鉴定/GBC)的连接** - **品种判别**(单一品种归类): 把每个 SNP 视作一个特征。若已知每个品种 y 的等位基因频率 p_{ky},在 HWE 下

P(\text{AA}\mid y)=p_{ky}^2,\quad P(\text{Aa}\mid y)=2p_{ky}(1-p_{ky}),\quad P(\text{aa}\mid y)=(1-p_{ky})^2.

这样可直接带入$∑klog⁡P(基因型k∣y)+log⁡P(y)$做分类(记得∗∗平滑∗∗,比如把p做Beta正则化)。−∗∗血统成分估计∗∗(混合而非单一类别):朴素贝叶斯本体是单类判定。GBC想要的是混合权重$w$使

P(x_k\mid \mathbf{w})=\sum_{b} w_b, P(x_k\mid \text{breed}=b).

这更像 **混合模型** 或 **EM/MAP 估计** 的问题;你可以把上式作为似然去优化 $\mathbf{w}$(加 Dirichlet 先验做贝叶斯化)。朴素贝叶斯的“条件独立”想法仍可用在 SNP 之间。 ## 基于贝叶斯的品种预测 假设每个品种在各SNP位点上ALT等位基因的频率如下: ![image.png](https://picbed.guoyingwei.top/2025/08/202508081800299.png) 每个个体基因型: ![image.png](https://picbed.guoyingwei.top/2025/08/202508081800490.png) 问题可以转化为求解每个个体分别为品种A B C的后验概率: 是品种A的概率为:

P(A\mid ind1)==\frac{P(ind1\mid A),P(A)}

其中:−∗∗先验∗∗:$P(A)$。不看特征,样本属于p品种A的“总体比例”。−∗∗似然∗∗:$P(ind1∣A)$。如果它真是$A$,出现这些特征$ind1={x1,…,xn}$的概率。−∗∗后验∗∗:$P(A∣ind1)$。已知个体基因型之后,它属于品种A的概率(我们真正想比较的)。$P(ind1∣A)$就表示品种A出现各每个位点基因型的概率的乘积:

P(ind1\mid A) = P(g1=2|A)×P(g2=0|A)=p1^2×(1-p2)^2 =0.64 × 0.64 = 0.4096

$P(A)$表示属于品种A的比例,可以直接是1/3或者按样本比例

P(A)=1/3

$P(ind1)$等于总样本分之一,每个样本被抽到的概率是一样的,所以可以不用管,只需要比较分子大小。同样的方法,计算B品种:

P(ind1\mid B) = P(g1=2|B)×P(g2=0|B)=p1^2×(1-p2)^2 =0.09 × 0.09 = 0.0081

C品种:

P(ind1\mid C) = P(g1=2|C)×P(g2=0|C)=p1^2×(1-p2)^2 =0.3025 × 0.36 = 0.1089

只看分子,是品种A的可能性最大。 其他个体依次类推,即可判定出每个个体最有可能所属的品种,这就是朴素贝叶斯方法进行分类任务。 --- ## 参考 > [!note] > [贝叶斯分类器就是朴素贝叶斯吗,朴素贝叶斯和贝叶斯定理,贝叶斯统计学的关系是什么?](贝叶斯分类器就是朴素贝叶斯吗,朴素贝叶斯和贝叶斯定理,贝叶斯统计学的关系是什么?.md) > [阮一峰:朴素贝叶斯分类器的应用](阮一峰:朴素贝叶斯分类器的应用.md) > [贝叶斯定理的应用——雷琼牛精准鉴定](贝叶斯定理的应用——雷琼牛精准鉴定.md) >